没有哪个助理能一次就做对
rysOS,我正在 Raspberry Pi(树莓派)上训练的行政助理
我想要一位行政助理。它能读我的日程、我的邮件、我刚开完的那场会议的纪要,以及我在车里录的语音,并且拿这些做点有用的事,而不必让我打开某个界面,告诉它每样东西该存在哪里。
没有人一上岗就知道老板怎么做事。人类助理在最初几周会出错,会问很多问题,慢慢才弄清谁是谁、什么紧急、什么可以等。AI 助理也是一样。它同样不会一次就做对,而最常见的错误,就是忘了这一点,还期待拿到一个成品。
我就是这样对待 rysOS 的。它读取我真实的信息来源:Google Calendar、Gmail、会议转录稿和我的语音日记,然后写进一个笔记库(vault),也就是我用纯文本文件存放笔记的文件夹。它作为一项服务运行在我的 Raspberry Pi 上,只属于我一个人。它最重要的一点是会跟着我学习。我纠正,它记住纠正,目的是让它随着时间推移越来越少需要帮助。我的角色是跟进、纠正和教导。这篇文章讲的就是这一切在实践中如何运转。
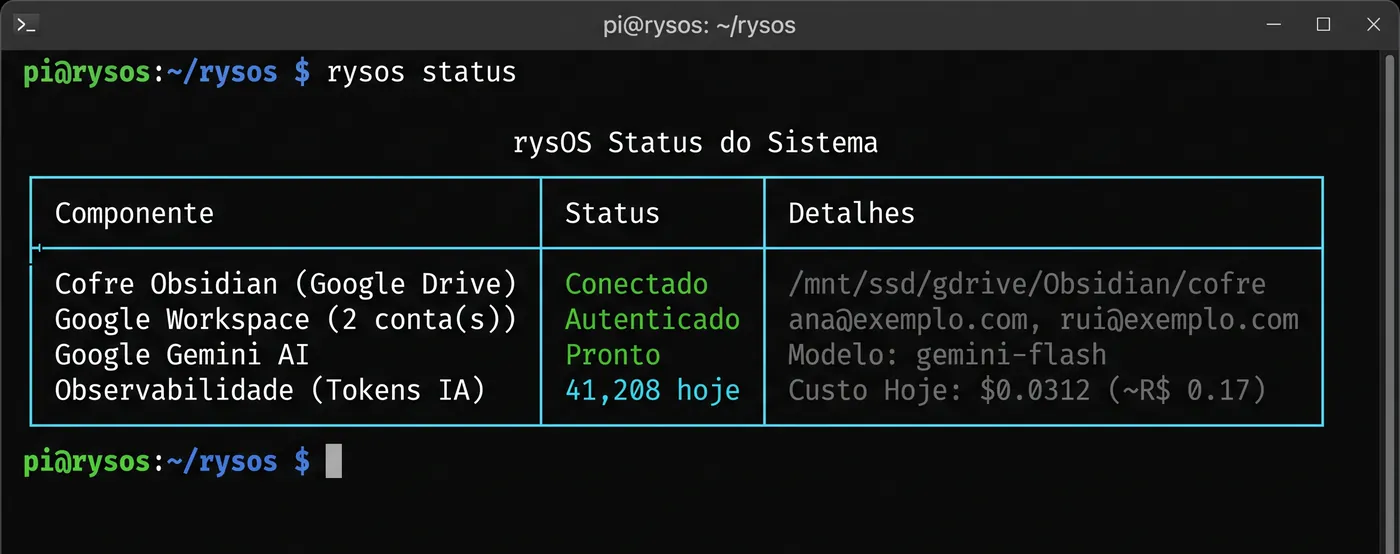
不知道就会发问的助理
我对它的第一个要求,是绝不编造。给普通聊天机器人一个没有描述的日历邀请,让它给出会议议程,它会交出一份看似合理、文笔漂亮、却是假的议程。对于一份将成为我决策历史的记录,这是不能接受的。所以,当邀请没有议程时(实际判断标准是描述不足十五个字符),系统根本不会去调用模型。摘要只会写明这个邀请没有议程。读起来更干巴,我更喜欢这样。
同样,当转录稿里提到某个人、某个项目或某项决定,而它无法确定地关联到已有内容时,它会发问。它会创建一份分诊笔记,每个疑问一行,我直接在 Obsidian 里用一个词回答:NOVO 表示新建,"= Nome Exato" 表示关联到已有的某条笔记,IGNORAR 表示丢弃。(这些指令是葡萄牙语,和系统的其他部分一样。)如果同一个人在其他转录稿里也待处理,这个回答对所有转录稿都有效。我回答一次,它就不会忘。
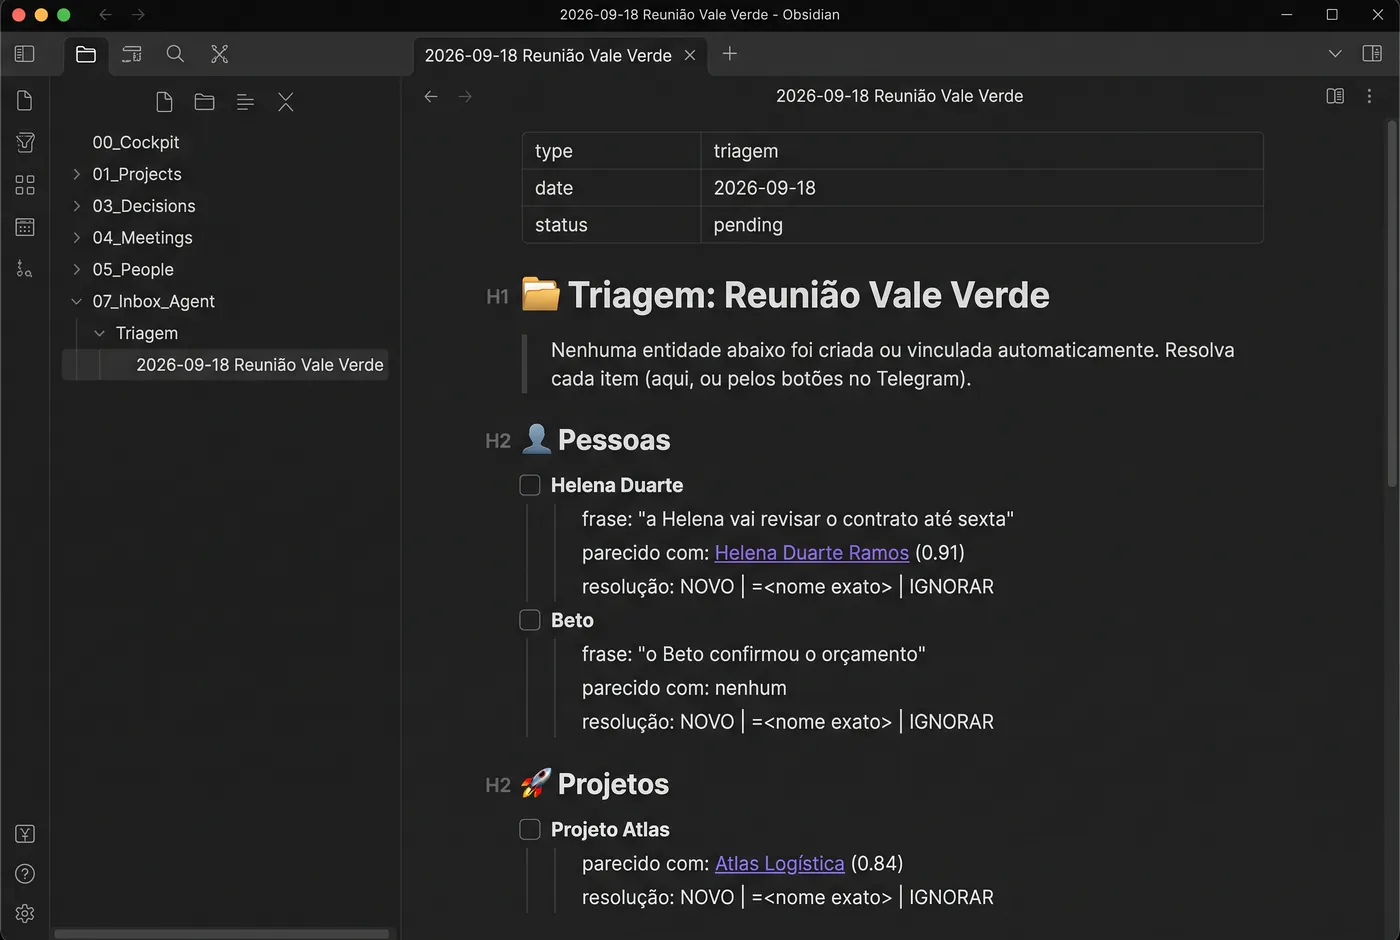
它还会记住学到的东西。它记录反复出现的术语,以及我确认或纠正它对某条消息所作分类的次数,并在之后的处理中再次使用这些记录。
它的一天
早上七点,它拉取当天的日程和新邮件,并为每场会议准备一份已知信息的摘要。今天到期的账单会成为当天看板上的一个焦点事项,之后到期的则变成提醒。每隔十五分钟,它会查看一个文件夹。当我把一场会议的转录稿放进去,或者语音日记已转成文字送到,它就会生成会议纪要、创建笔记,并保存原始文件。
我通过 Telegram 和它对话。我提的问题不会变成笔记,含糊的记录会得到一条回复而不是变成草稿,而 "boleto pago"(账单已付)会关闭对应的焦点事项。晚上十一点,当天的总结会送达。
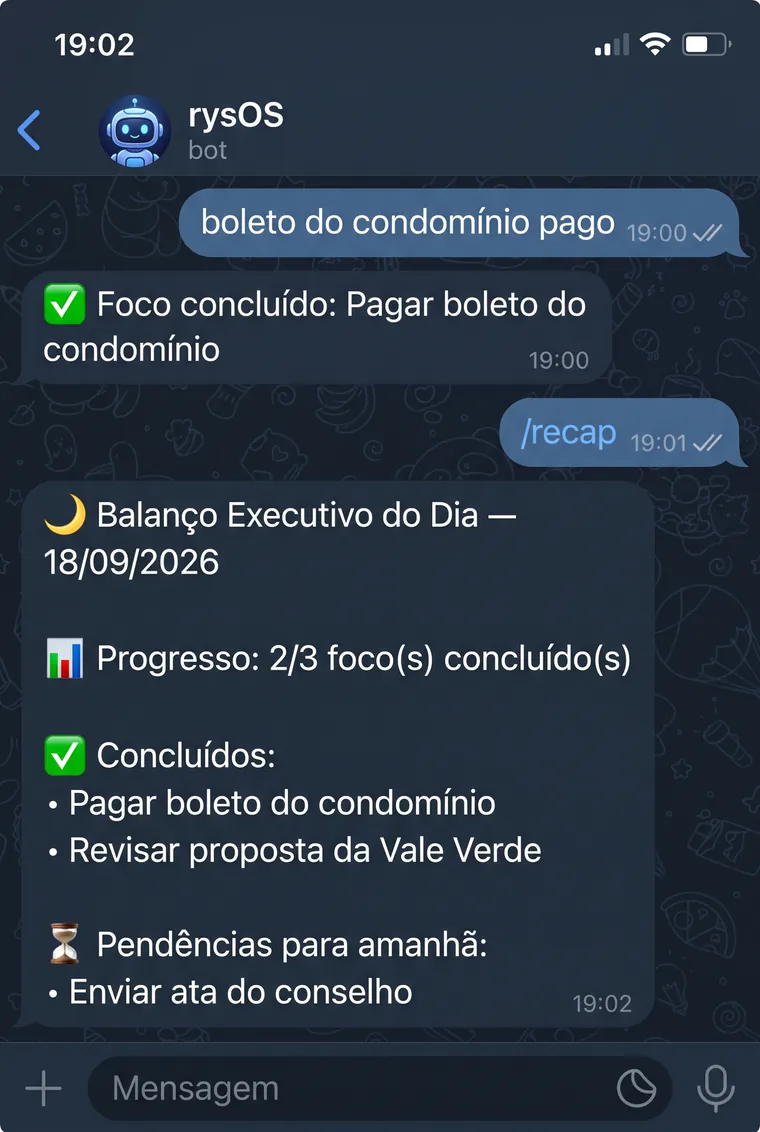
它在犯错中学到了什么
它犯的错有些出乎我的意料,而每个错误都改变了它今天的做法。
因为两个名称相同,它花了一天半的时间,每隔十五分钟就重新创建同样的决策,在文件夹里留下了 730 多个重复文件。现在,某一项决策出问题不会影响其他决策。在这一点上它还没有完全掌握窍门,因为决策的名称仍可能冲突,我仍在盯着。
对于通过我其他邮箱账号收到的会议,它认不出我,还创建了一个指向不存在笔记的链接。没有人提醒我,我是事后才发现的。现在它会使用我全部邮箱地址的完整列表。
有一份报告曾说,我的 27 条资源笔记里有 26 条是重复的。我在合并之前先去查看,结果是 26 条互不相同、只是名称一样的笔记。全部合并会毁掉整个收藏。每一条都换了新名称。这个错误出在报告上,发现它的是我。
笔记库扫描曾因为 Google Drive 连接的一项设置而耗时超过 20 分钟。我调整之后,现在大约需要 11 秒。
我坚持的规则
陪着助理成长,就是坚持几条不变的规则,即使放松它们看起来更好。
结构,包括文件夹、字段和链接,始终由代码生成,模型只负责写句子。这样一来,当一条笔记出错时,我能分清问题出在代码,还是出在 AI 写的某句话。信息缺失本身也是一种信息,所以它会说不知道,而不是把空白填满。它按实际发生的事情来识别对象:会议按日期和参与者,账单按到期日和收款方,转录稿按文件内容。因此,转发的邮件或被放进去两次的文件,永远不会生成两条笔记。
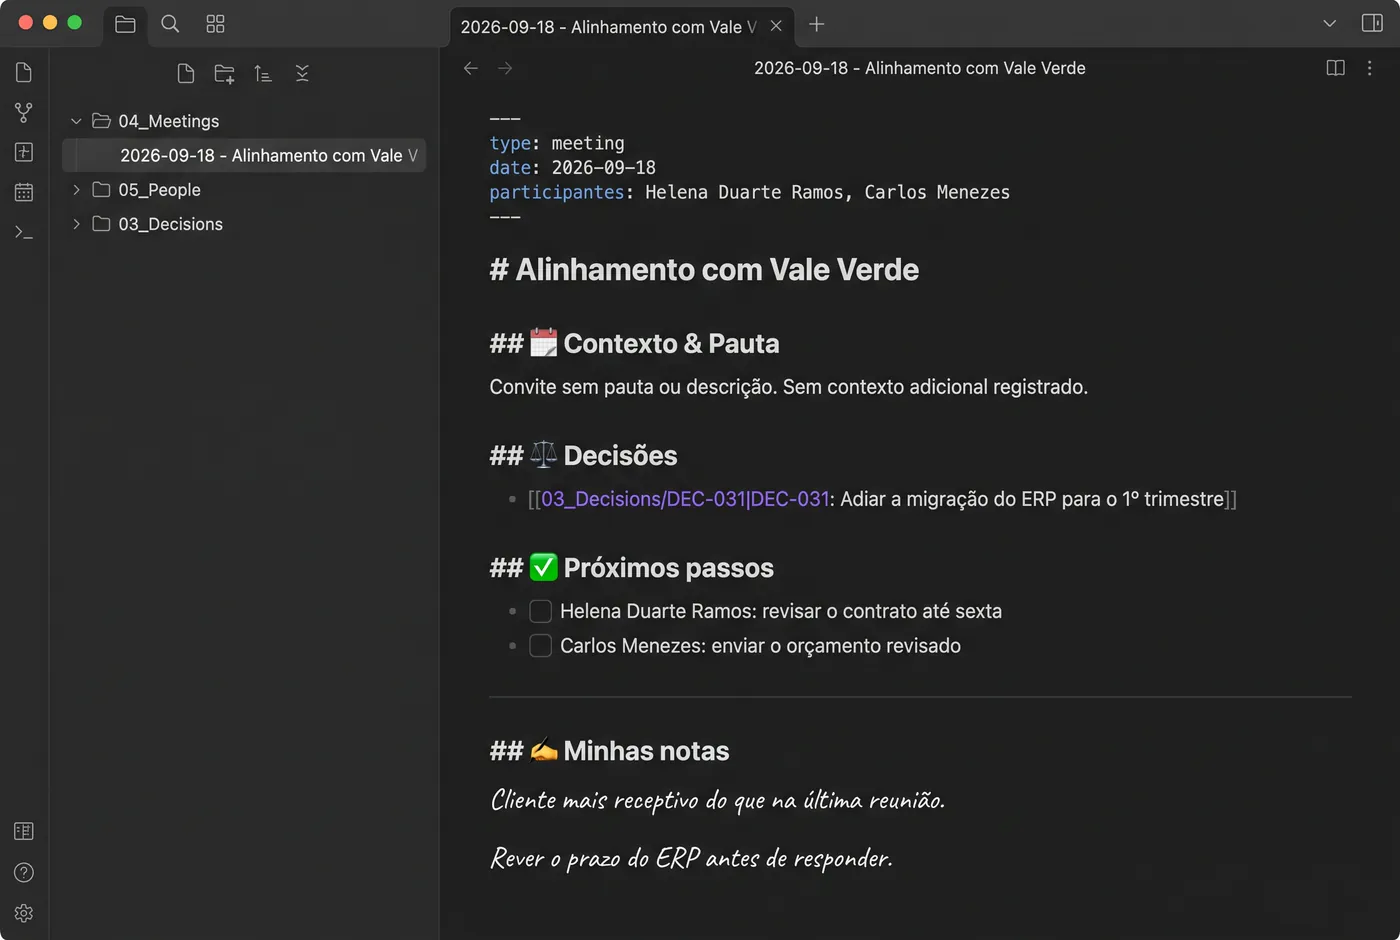
笔记库有四个固定领域:商业与治理、健康与活力、资产与财务、家庭与关系。词汇表封闭,我就可以问 "健康领域有哪些待办",并得到完整的答案。在会议笔记里,机器写的内容在顶部,我写在正文里的内容永远不会被覆盖。
而且笔记库就是一个与 Google Drive 同步的 Markdown 文件夹。就算 Obsidian 明天消失,这些文件仍在原地,任何 AI,包括现在还不存在的 AI,都能读取它们。
它不做什么
凡是需要判断力的事,人类助理都做得更好:谈判、察言观色、决定什么不该做。如果你的瓶颈是判断力,请雇一个人。
配上日程和邮件插件的聊天机器人搭建起来更快。但没有人监督,它总有一天会编出一个看似合理的东西,而你要等到把这个假事实用进真实决策之后才会发现。无代码工具更适合团队。rysOS 面向的是一个人:一个 Google 账号、一个笔记库、Telegram 上一位授权用户。这是一个真实的局限。
可以期待什么
它不替我做决定。它做的是随着我的跟进而变得更好。一场会议无需我打字就变成笔记。一个在六场会议中被提到的人,会在自己的页面上积累历史,而这份历史不是我写的。今天记录的一项决策,是三个月后我要重读的一行字,用来判断当时我是否判断正确。我已经知道的一切都不会丢失,它不知道的一切都不会被编造,所有内容都能追溯到来源。
这一切只在我持续关注时才成立。如果我不再跟进,它就停止学习,错误又会在无人察觉中溜过去。我写这篇文章就是为了提醒自己:rysOS 是一位新助理,而新助理需要关注,也需要时间来上手。
代码
代码在 GitHub 上,名称为 meOS:github.com/rodrigoyujisato/meOS。它是开源的,采用 MIT 许可证。姓名、邮箱和路径都变成 .env 文件中的配置,仓库里不保存我的任何数据。运行它需要一个 Gemini 密钥;如果想让它读取日程和邮件,还需要一个 Google 账号。README 里有分步说明,系统使用葡萄牙语。
谢谢你,Luis
Luis Alt,谢谢你的启发,让我去探索 Obsidian 的各种可能,这来自你的 LifeOS(luisalt.com/LifeOS)。我钦佩你作为专业人士,你在巴西和世界各地的服务设计领域有着深厚的经历。我更钦佩你这个人,总是善良而才华横溢。
祝好,Rodrigo